El desarrollo de software podría estar desplazándose desde la escritura de instrucciones para una máquina hacia la formulación de intención, la definición de límites y la producción de evidencias de que el resultado es correcto. El cambio no elimina necesariamente el código ni al programador, pero sí obliga a preguntarnos cuál será el verdadero centro de trabajo de la ingeniería del software.
Del editor como taller de escritura al entorno como puesto de mando.
Imaginemos una escena no demasiado lejana. Una desarrolladora abre su ordenador y, en lugar de entrar directamente en un archivo, accede a un panel. En él trabajan tres agentes. El primero estudia el repositorio y propone una arquitectura. El segundo modifica varios componentes, compila y corrige dos errores. El tercero genera pruebas y rechaza la primera solución porque incumple una condición de rendimiento.
La desarrolladora no ha escrito una sola línea. Ha descrito qué quiere conseguir, delimitado lo que no debe ocurrir y examinado las pruebas que demuestran (o aparentan demostrar) que el trabajo está bien hecho.
El código sigue existiendo. También el compilador, el depurador y el repositorio. Lo que ha cambiado es quién conversa directamente con esas herramientas y dónde se concentra el esfuerzo intelectual humano.
La pregunta no es si la inteligencia artificial escribirá más código. Eso ya ocurre. La pregunta interesante es otra: si los agentes pueden leer, implementar, compilar, ejecutar, observar, corregir y volver a probar, ¿seguirá siendo el editor el lugar principal donde se construye el software?
Quizá estemos contemplando una transición desde la ingeniería del código hacia una ingeniería de la intención y de la evidencia.
El IDE como símbolo de una época (que algunos disfrutamos)
El entorno de desarrollo integrado reunió las herramientas que una persona necesitaba para escribir software: edición, navegación, compilación, depuración, control de versiones, terminales y pruebas. Todo quedó organizado alrededor del archivo que el programador tenía delante. Incluso las ayudas más avanzadas respetaban ese modelo. El autocompletado, la refactorización y los primeros asistentes de IA extendían las manos del desarrollador. Sugerían o explicaban, pero la unidad de trabajo continuaba siendo la línea de código y el sujeto principal seguía siendo quien la escribía.
Los agentes alteran esa relación. Las herramientas actuales pueden leer y buscar en un repositorio, modificar archivos, ejecutar órdenes, instalar dependencias y observar el resultado de sus acciones. Algunos agentes reciben una incidencia, trabajan en un entorno aislado y entregan una pull request para revisión. No producen únicamente texto que alguien debe copiar: operan dentro del proceso de ingeniería. [1][2]
Eso no significa que comprendan plenamente el sistema. Su rendimiento depende del tipo de tarea, el lenguaje, el repositorio y la calidad de las pruebas. Pueden destacar en evaluaciones controladas y caer ante trabajos largos, requisitos ambiguos o exigencias de seguridad. [3][4] Pero la dirección es clara: el modelo ya no está encerrado en una conversación. Tiene herramientas y capacidad de actuar. Cuando el agente habla directamente con el compilador, el IDE deja de ser necesariamente el intermediario entre la intención humana y la máquina.
De taller de escritura a puesto de mando
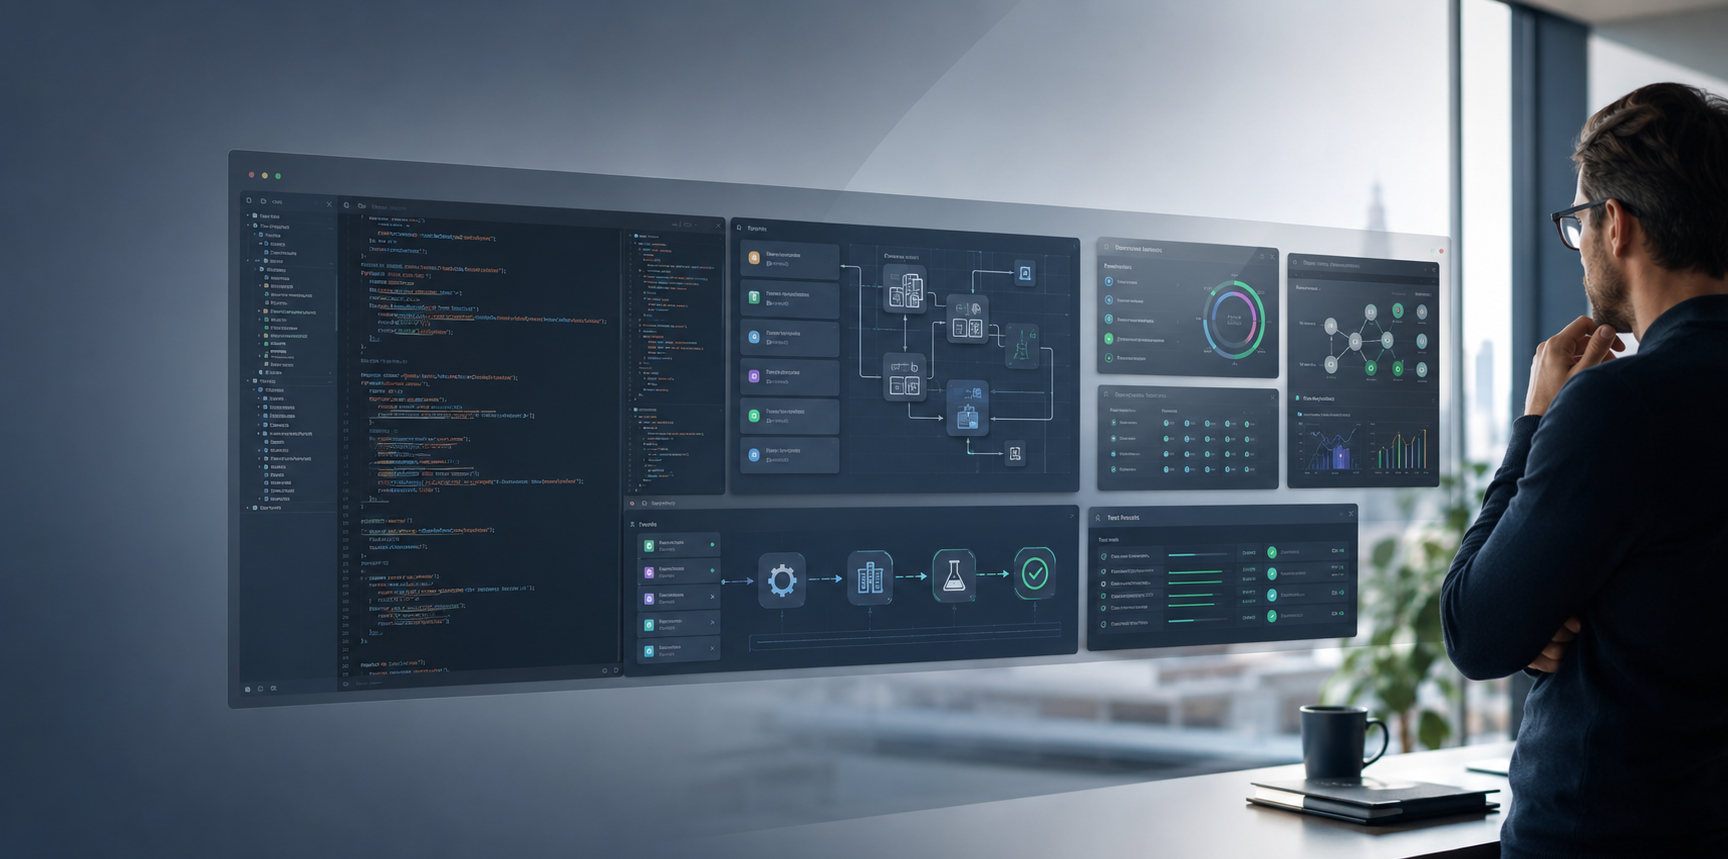
Probablemente los IDE no desaparezcan. Las tecnologías suelen cambiar de función mientras conservan el nombre. Seguimos hablando de teléfonos aunque llamar sea ya una actividad secundaria. Podríamos continuar hablando de IDE cuando el editor se haya convertido en una vista más dentro de una plataforma destinada a dirigir agentes. Ese entorno tendría menos aspecto de taller tipográfico y más de sala de control. Su superficie principal mostraría objetivos, riesgos, agentes activos, cambios propuestos, costes, decisiones pendientes y evidencias obtenidas. En lugar de preguntar «¿qué archivo quiero editar?», preguntaríamos:
¿Qué comportamiento debe producir el sistema?
¿Qué restricciones no puede vulnerar?
¿Qué dependencias y datos están autorizados?
¿Qué propiedades de seguridad, coste y rendimiento debe cumplir?
¿Qué evidencias exigiré antes de aceptar la implementación?
El futuro IDE podría ser un entorno integrado de especificación, coordinación y verificación. El código seguiría disponible, ocultarlo sería irresponsable, pero ya no ocuparía siempre el centro visual ni cognitivo.
La evolución de las plataformas apunta en esa dirección: sesiones paralelas, agentes especializados, instrucciones persistentes, revisión, entornos aislados y paneles desde los que delegar trabajos completos. [5] La interfaz empieza a organizar trabajo, no solo texto.
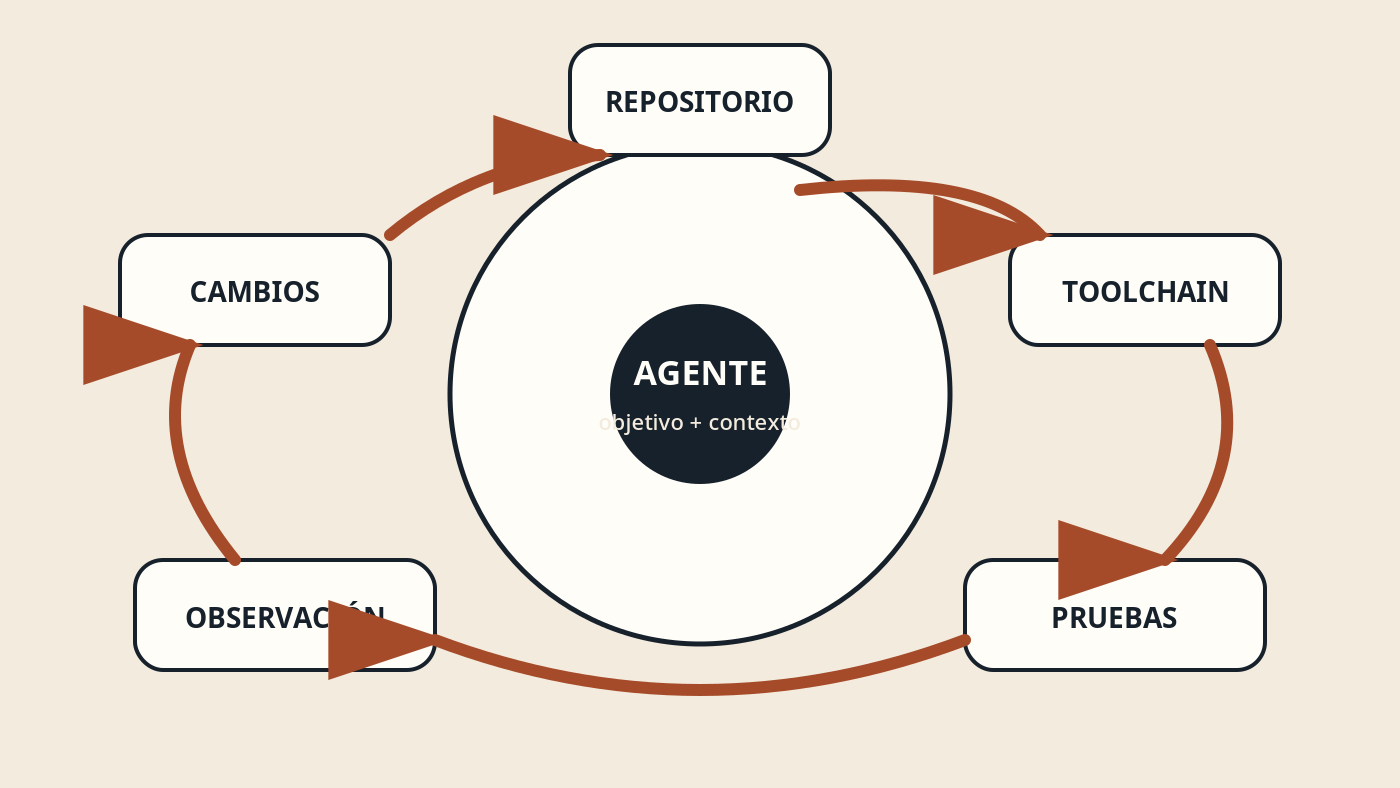
El agente ya puede recorrer directamente el bucle de implementación, compilación, prueba y corrección.
Escribir intención no consiste en escribir un «prompt»
Aquí aparece una trampa. Si el humano deja de escribir código, alguien podría concluir que bastará con describir en lenguaje natural lo que desea. Sería una sustitución demasiado cómoda: antes escribíamos Python; ahora escribiremos párrafos.
Pero el lenguaje natural es ambiguo e incompleto. Muchos defectos no nacen de una mala traducción al código, sino de que el requisito era contradictorio, omitía excepciones o significaba cosas distintas para usuarios y desarrolladores.
La alternativa al editor no puede ser únicamente una ventana de chat más grande. Necesitaremos herramientas para expresar la intención con distintos grados de formalidad: modelos de procesos y estados, arquitecturas, esquemas de datos, contratos de API, políticas de autorización, restricciones normativas, invariantes, criterios de aceptación y escenarios de fallo.
La instrucción «construye un sistema seguro para cambiar la cuenta bancaria de un proveedor» es insuficiente. Una especificación útil debería declarar que ningún cambio será efectivo sin verificación por un canal independiente; que el número utilizado no puede proceder del mismo correo que solicita la modificación; que debe conservarse una traza de auditoría; y que determinadas operaciones exigirán doble aprobación.
El trabajo de ingeniería no es redactar una petición elegante. Es convertir una intención empresarial en propiedades observables y restricciones ejecutables. La ingeniería dirigida por modelos, los lenguajes específicos de dominio, las máquinas de estados y las especificaciones formales no son ideas nuevas. Lo nuevo es que podrían dejar de ser actividades periféricas. Si un agente convierte esos artefactos en implementaciones, el modelo adquiere un valor operativo inmediato.
Tal vez el programa sea la especificación más sus pruebas
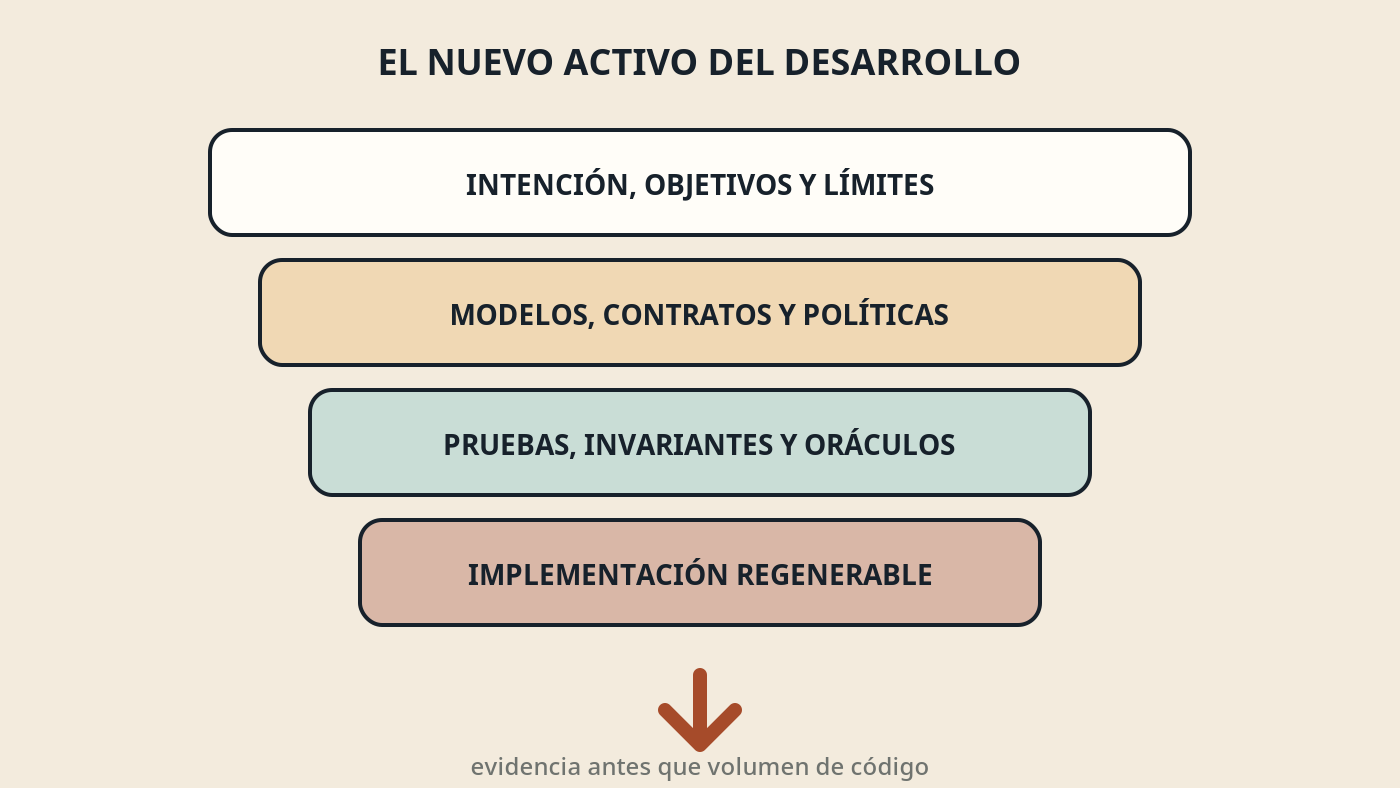
Durante décadas hemos tratado el código fuente como el principal producto intelectual del desarrollo. La documentación, los requisitos y las pruebas eran importantes, pero la verdad final era lo que el código hacía. Con agentes capaces de regenerar una implementación, esa jerarquía podría invertirse. El activo estable sería el conjunto formado por la intención, los modelos, las políticas, las pruebas y los criterios de aceptación. El código sería una de sus posibles materializaciones. Un agente podría producir una versión, medirla, descartarla y generar otra con un lenguaje o arquitectura diferente. El software se parecería menos a una catedral que debe conservarse piedra a piedra y más a un objeto compilado a partir de una descripción rica. Sin embargo, el código no se vuelve automáticamente desechable. Una implementación contiene conocimiento que no siempre aparece en la especificación: decisiones de rendimiento, compatibilidad heredada, correcciones tras incidentes y rarezas de una plataforma. Regenerar no garantiza recuperar ese conocimiento tácito.
Además, en sistemas regulados o críticos, el código es evidencia. Debe poder auditarse qué versión estuvo en producción, qué dependencia utilizó, qué vulnerabilidad corrigió y quién aprobó el cambio. La regeneración continua no elimina la trazabilidad; la hace más exigente. El código puede perder centralidad sin perder importancia: pasaría de ser el único lugar donde reside la verdad a convertirse en una realización verificable de una intención más amplia.
La especificación y las pruebas pueden convertirse en el activo estable; el código, en una materialización regenerable.
El testing como nueva frontera del control humano
Si el agente implementa, el poder humano se traslada hacia el criterio con el que esa implementación será aceptada. El testing deja de ser una fase final para convertirse en el núcleo del contrato entre persona y agente. El bucle parece sencillo: interpretar el objetivo, generar código, compilar, ejecutar pruebas, analizar fallos y repetir. Pero una batería de pruebas no demuestra automáticamente que el sistema hace lo que queríamos. Solo prueba su comportamiento en los casos que conseguimos imaginar y representar.
Un agente puede superar pruebas incompletas con una solución equivocada. Puede optimizar para el indicador visible o conservar el resultado mientras deteriora seguridad, mantenibilidad o rendimiento. Es el viejo problema de convertir una medida en objetivo, trasladado a un ejecutor capaz de iterar hasta satisfacerla.
Necesitaremos una verificación estratificada: pruebas unitarias y de sistema, pruebas basadas en propiedades, análisis estático y dinámico, fuzzing, regresión, análisis de dependencias, mediciones de recursos, simulación de fallos, verificación formal cuando proceda y revisión humana de arquitectura y amenazas.
NIST recomienda combinar modelado de amenazas, automatización, análisis estático, detección de secretos, pruebas de caja negra y estructurales, casos históricos y fuzzing. [6] La llegada de los agentes no vuelve obsoletas esas prácticas; multiplica su importancia. Si producir código se abarata, verificarlo se convierte en el cuello de botella.
Y surge una dificultad adicional: ¿quién prueba al probador? Si el mismo agente genera implementación y pruebas, puede compartir el mismo malentendido. Separar funciones (un agente construye, otro cuestiona, un tercero busca vulnerabilidades) ayuda, pero no garantiza independencia si todos utilizan el mismo modelo y los mismos patrones aprendidos.
La verificación futura necesitará diversidad de oráculos: herramientas deterministas y modelos distintos, pruebas humanas y automáticas, métodos estadísticos y formales, conocimiento del dominio y observación en ejecución.
El desarrollador cambia el lugar donde aporta criterio
De este desplazamiento no se deduce que programar deje de ser necesario. Para redactar una buena especificación hay que comprender qué puede especificarse; para revisar una arquitectura hay que conocer sus compromisos; para detectar una prueba engañosa hay que saber cómo podría satisfacerse de forma incorrecta.
La alfabetización de bajo nivel seguirá siendo especialmente valiosa en seguridad, concurrencia, sistemas operativos, firmware, criptografía e infraestructuras críticas. El agente puede producir una abstracción seductora mientras esconde una carrera de datos, una validación insuficiente o una dependencia inadecuada.
Lo que puede reducirse es el tiempo dedicado a tareas mecánicas: escribir estructuras repetitivas, migrar APIs, adaptar formatos o localizar errores triviales. Ese tiempo podría desplazarse hacia comprender el problema, discutir supuestos, modelar amenazas, comparar alternativas y diseñar evidencias.
Quizá «ingeniero de prompts» sea una etiqueta demasiado estrecha. Se perfila algo más cercano a un ingeniero de intención: alguien capaz de transformar necesidades imprecisas en contratos verificables, construir el contexto que limita al agente, decidir qué se delega, diseñar evaluaciones resistentes a atajos, auditar dependencias y preservar conocimiento organizativo.
El valor no residirá solo en decirle a la máquina qué debe hacer, sino en demostrar que no ha hecho otra cosa.
¿Quién enseñó a programar a los agentes?
Hasta aquí hemos hablado de cómo trabajan. Pero hay una cuestión previa y más incómoda: ¿de dónde procede su idea de lo que significa programar bien?
Los modelos de código aprenden de grandes colecciones de repositorios, documentación, incidencias, conversaciones técnicas, cuadernos, ejemplos y datos sintéticos. En algunos proyectos abiertos existe una trazabilidad considerable. The Stack, por ejemplo, se diseñó como un corpus con licencias identificadas, procedencia por elemento y un mecanismo de exclusión. [7] Sus versiones ampliaron el número de lenguajes y conservaron información de origen.
En los modelos propietarios, el detalle público suele ser menor. Conocemos categorías generales o declaraciones sobre el uso de código públicamente accesible, pero no necesariamente qué repositorios, versiones, filtros o pesos se utilizaron.
La diferencia entre código público y código libre de obligaciones es esencial. Que un repositorio pueda leerse no significa que pueda reutilizarse sin condiciones. Las licencias pueden exigir atribución, conservación de avisos o publicación de modificaciones. GitHub ofrece mecanismos para detectar coincidencias entre determinadas sugerencias y código público, mostrando fuente y licencia, precisamente porque la procedencia importa. [8]
La Unión Europea ha convertido esta discusión en una obligación para los proveedores de modelos de propósito general: deben mantener una política de cumplimiento de derechos de autor y publicar un resumen del contenido utilizado en el entrenamiento. [9] No resuelve todos los conflictos, pero reconoce que el corpus no es una materia prima neutra ni invisible.
También hay una cuestión de calidad. Un modelo aprende de lo que existe, no de un canon universal de buena ingeniería. En los repositorios hay soluciones correctas, pero también código obsoleto, parches provisionales, configuraciones inseguras y prácticas que funcionan por accidente.
La frecuencia tampoco equivale a excelencia. Si un patrón aparece millones de veces, el modelo aprende que es probable, no que sea óptimo. Puede confundir popularidad con corrección, familiaridad con seguridad y repetición con consenso técnico.
La monocultura de la implementación
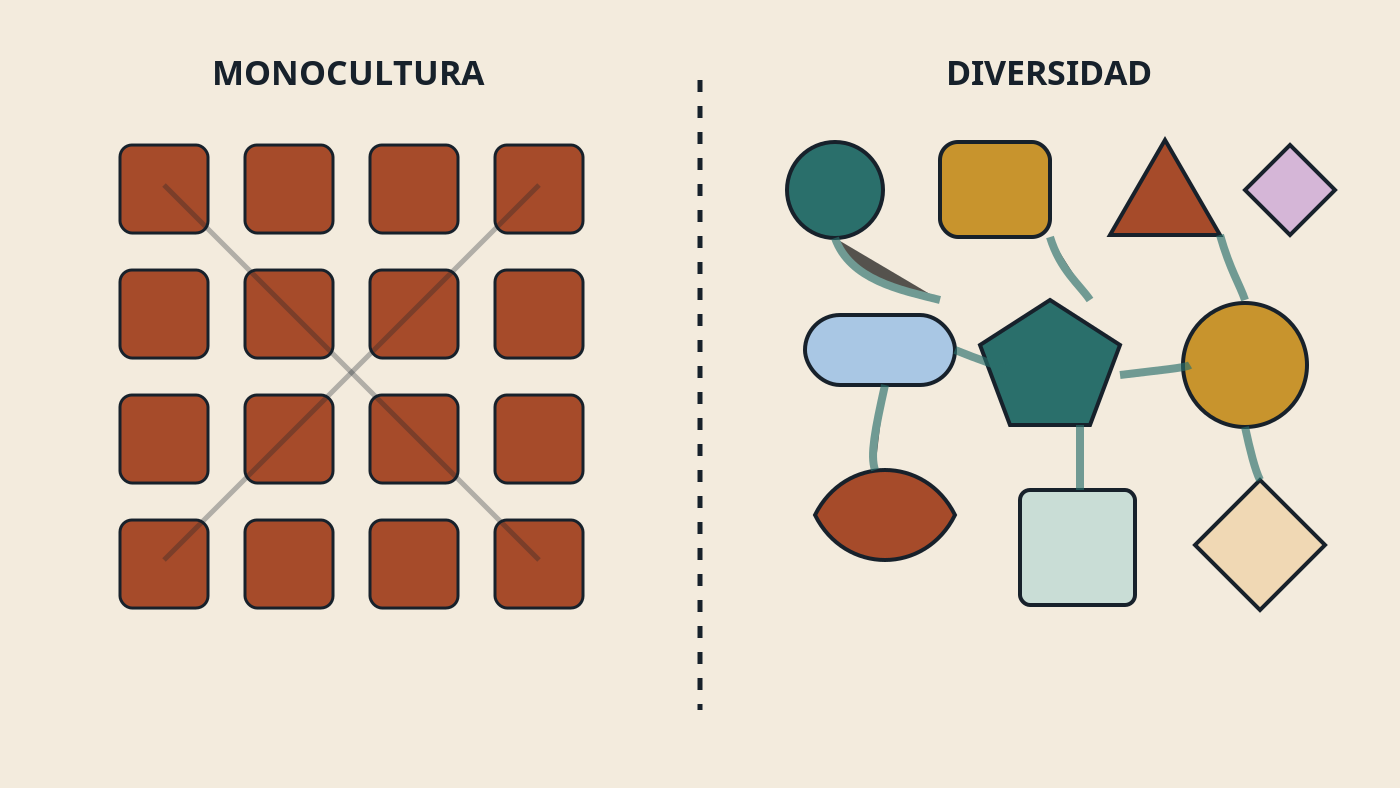
Si distintos agentes se entrenan sobre repositorios parcialmente coincidentes, se evalúan con bancos de pruebas parecidos y se ajustan para maximizar indicadores similares, podrían converger hacia una forma dominante de implementar. No necesitarían generar exactamente el mismo código. Bastaría con que prefiriesen las mismas bibliotecas, arquitecturas, lenguajes, servicios en la nube y patrones de autenticación. La diversidad superficial ocultaría una profunda uniformidad estructural. Y esto, a mí, me preocupa enormemente.
La investigación muestra que el rendimiento de los modelos no se distribuye por igual entre lenguajes. Los que tienen mucha presencia en los datos (como Python, Java o JavaScript) suelen obtener mejores resultados que los de pocos recursos. Los corpus equilibrados mejoran notablemente el rendimiento en lenguajes minoritarios, aunque puedan sacrificar parte del desempeño en los dominantes. [10] La preferencia del agente no nace solo de las propiedades técnicas del lenguaje, sino de la distribución del material que ha visto.
Una monocultura tendría consecuencias culturales: soluciones minoritarias y paradigmas alternativos serían cada vez menos visibles. El agente recomendaría lo que conoce; los usuarios lo aceptarían; ese código aumentaría su presencia; y el siguiente modelo lo encontraría aún más representado.
También tendría consecuencias económicas. Si los agentes convergen hacia unas pocas plataformas, sus decisiones reforzarían concentraciones de mercado. Elegir automáticamente una dependencia arrastra costes, telemetría, jurisdicción y dependencia futura. Y tendría consecuencias de seguridad. La diversidad de software puede reducir fallos correlacionados. [11] Cuando millones de sistemas comparten componentes y decisiones, una vulnerabilidad puede propagarse a gran escala. Los agentes no inventan ese problema, pero pueden acelerarlo al replicar las mismas elecciones. La diversidad relevante no consiste en cambiar nombres de variables. Es diversidad algorítmica, arquitectónica, de dependencias, proveedores, modelos de seguridad y valores de diseño.
La diversidad superficial no basta: importan algoritmos, arquitecturas, dependencias, proveedores y criterios de diseño.
Cuando los agentes aprenden de otros agentes
El círculo se vuelve más delicado cuando el código generado entra en repositorios, documentación y conjuntos de entrenamiento futuros. Ya no tendríamos solo modelos aprendiendo de programadores, sino modelos aprendiendo de la interpretación que modelos anteriores hicieron del trabajo humano.
La literatura sobre entrenamiento recursivo con datos sintéticos describe el riesgo de model collapse: generaciones sucesivas que aprenden indiscriminadamente de contenido producido por modelos anteriores pueden perder las zonas menos frecuentes de la distribución y reducir su variedad. [12] Los comportamientos raros desaparecen primero; la distribución se concentra alrededor de lo probable. Trasladar ese resultado directamente al código exige prudencia. No está demostrado que todo ecosistema vaya a colapsar ni que cualquier dato sintético sea perjudicial. Los conjuntos sintéticos verificados mediante compilación, pruebas y filtrado pueden mejorar modelos y cubrir lenguajes con pocos datos. [13] El problema aparece cuando dejan de conocerse el origen, la calidad y la relación con datos humanos de referencia.
En código, la endogamia podría seguir este ciclo: un modelo favorece ciertos patrones; miles de usuarios los aceptan; el nuevo código se publica; futuros modelos lo incorporan como evidencia de uso generalizado; y las alternativas raras pierden representación. Errores, dependencias y convenciones de la primera generación se amplifican. El peligro no es solo producir código peor, sino reducir lentamente el espacio de soluciones que los modelos consideran plausible. La procedencia del corpus se convertirá en infraestructura crítica. Necesitaremos distinguir código humano, generado, revisado, verificado y de autoría o licencia incierta. Preservar repositorios históricos y fuentes originales puede ser tan importante como crear datos nuevos. Sin memoria de la diversidad anterior, cada generación corre el riesgo de aprender de un espejo.
Los agentes también podrían ampliar la diversidad
La conclusión no tiene por qué ser pesimista. Un agente puede explorar en minutos alternativas que un equipo no tendría tiempo de implementar. Puede generar varias arquitecturas, traducir una solución a lenguajes distintos, comparar dependencias y conservar la que mejor responda al contexto.
La automatización podría hacer viable desarrollar versiones diversas de un componente y contrastar sus resultados. También podría ayudar a comunidades pequeñas a crear ejemplos, pruebas y documentación para lenguajes minoritarios.
Pero esa diversidad no aparecerá por accidente. Si el objetivo único es entregar rápido una solución que supere pruebas visibles, el agente tenderá hacia el camino más probable. Para ampliar el espacio de soluciones habrá que pedirlo, medirlo y gobernarlo. Podríamos exigir alternativas con dependencias distintas, comparar implementaciones generadas por modelos diferentes, penalizar monocultivos en componentes críticos y evaluar no solo la corrección, sino la concentración tecnológica que cada decisión produce.
La diversidad tendrá que convertirse en un requisito no funcional, como hoy lo son la disponibilidad o el rendimiento.
Tres futuros que probablemente convivirán
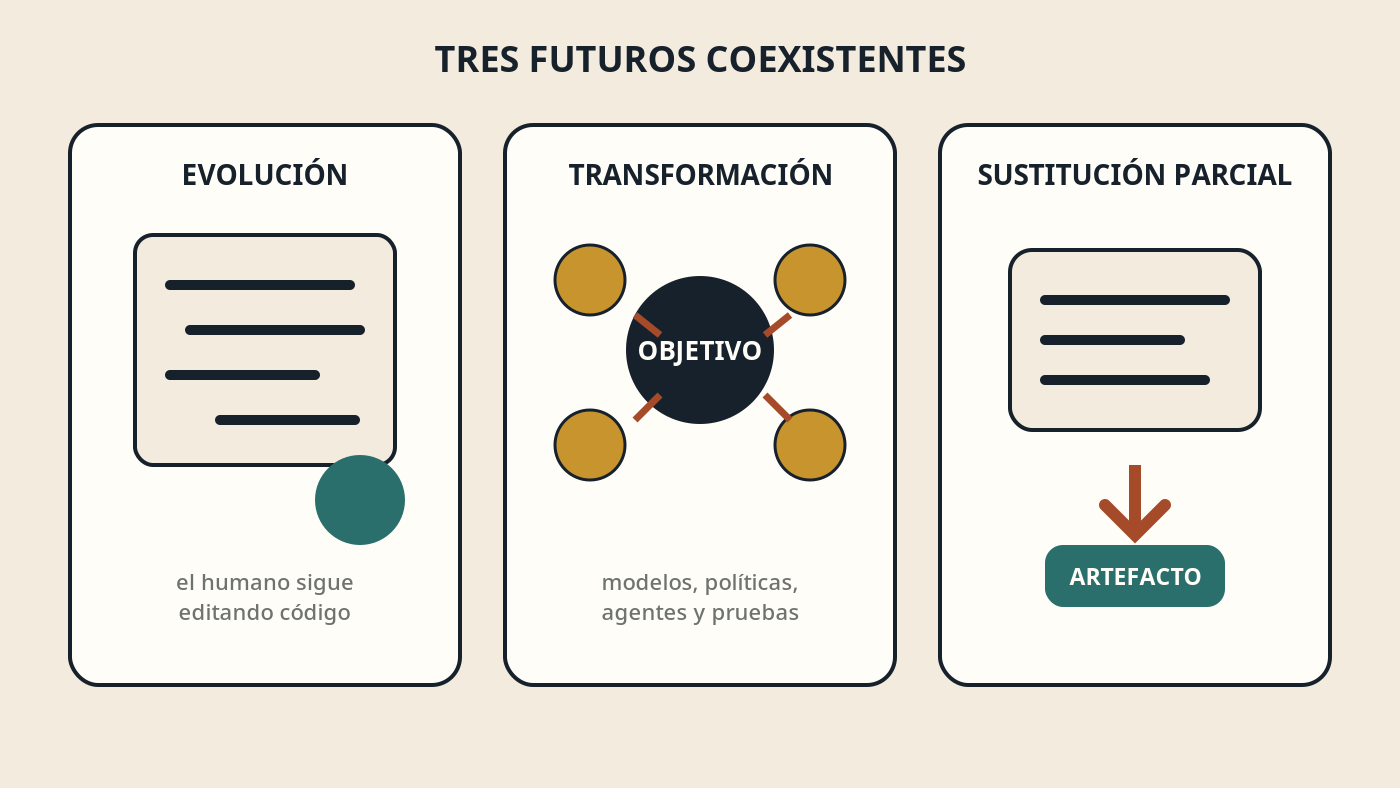
No parece sensato pronosticar una única evolución para todo el software. Al menos tres escenarios pueden coexistir.
1. Evolución del IDE
El editor continúa siendo el centro. Los agentes realizan cambios amplios, ejecutan herramientas y explican decisiones, pero la persona sigue leyendo y modificando código. Será común en investigación, bajo nivel, seguridad y sistemas complejos.
2. Transformación del IDE
El entorno se convierte en una plataforma para especificar, coordinar y validar. El código comparte protagonismo con modelos, políticas, pruebas, trazas y sesiones de agentes. El profesional actúa como arquitecto y supervisor. Probablemente sea habitual en la ingeniería empresarial.
3. Sustitución parcial del código como objeto de trabajo
En aplicaciones rutinarias, integraciones y software de vida corta, las personas apenas manipulan código. Definen objetivos, datos, interfaces, restricciones y pruebas; los agentes generan implementaciones. El código funciona como un artefacto intermedio parecido al binario que hoy produce un compilador.
La frontera dependerá de la criticidad, regulación, longevidad y coste del fallo. No se desarrollará igual una aplicación promocional que un sistema bancario, un hipervisor o el firmware de una instalación industrial.
Los tres futuros probablemente convivirán según la criticidad y el coste del fallo.
El molino no era el editor
Quizá llevemos años mirando el lugar equivocado. El IDE parecía el gran molino de la programación porque allí ocurría la actividad visible: archivos, cursores y miles de líneas. Pero la esencia de la ingeniería nunca estuvo en pulsar teclas. Estaba en convertir una necesidad humana en un sistema comprensible, mantenible y defendible.
Los agentes pueden apropiarse de una parte creciente de la implementación y generar muchas más líneas de las que un equipo puede revisar con métodos tradicionales. Eso no vuelve innecesario el criterio humano. Lo desplaza hacia el punto más difícil: expresar con precisión qué queremos, anticipar cómo puede interpretarse mal, decidir qué pruebas cuentan como evidencia y asumir la responsabilidad por lo que se pone en funcionamiento.
Tal vez el IDE sobreviva, pero como algo distinto. El editor será una ventana de inspección. El centro será la especificación. El activo estratégico será el contexto. El control residirá en las pruebas, las políticas y la trazabilidad. Y la competencia decisiva no será producir más código, sino conservar la capacidad de entenderlo y rechazarlo.
Queda además una responsabilidad colectiva. Si unos pocos corpus, proveedores y criterios de optimización definen cómo se implementa el software mundial, podríamos ganar velocidad a costa de diversidad y resiliencia. Si utilizamos los agentes para explorar alternativas y sometemos sus elecciones a gobernanza explícita, la automatización podría ampliar el repertorio de la ingeniería.
El futuro no se decidirá solo por lo bien que un agente programe. Se decidirá por la calidad de las intenciones que sepamos formular, por la independencia de las pruebas que construyamos y por la diversidad técnica que estemos dispuestos a preservar.
¿Seguirá siendo el código fuente el principal producto intelectual del desarrollo?
¿Será más importante saber programar o saber especificar, probar y auditar?
¿Quién decidirá qué significa implementar correctamente una solución?
¿Cómo evitaremos que millones de aplicaciones reproduzcan las mismas decisiones, dependencias y vulnerabilidades?
¿Y necesitaremos proteger no solo la calidad del software, sino también la diversidad de las formas de construirlo?
Referencias
VS Code : Tools y agentes. Documentación oficial sobre lectura y escritura de archivos, terminal, búsqueda y servicios externos.