Se bienvenido a estas tierras digitales...
...especialmente si eres un molino....
Máquinas Microarquitectónicas Informales(µWM): técnica emergente con potenciales implicaciones en seguridad y ofuscación de código.
Pueden entenderse como construcciones de código que permiten realizar computaciones a través de efectos secundarios y conflictos entre entidades microarquitectónicas como son los predictores de saltos y cachés.
Estas arquitecturas operan utilizando eventos no observables por las herramientas anti-ofuscación convencionales, lo que las hace ideales para la ofuscación de malware. Pueden usarse para realizar actividades fuera del modelo de seguridad. Además, dado que el estado actual de una arquitectura informal no se encuentra en la memoria regular sino que está codificado en el estado de los componentes microarquitecturales, las herramientas forenses tradicionales no pueden utilizarse para estudiar estas arquitecturas informales.
Se debe considerar que la capa microarquitectónica no es accesible directamente para los programas. Los programas pueden manipular implícitamente los componentes microarquitecturales (MA) al realizar una actividad regular. Ejemplos de componentes MA incluyen cachés, prefetchers y determinados buffers de la arquitectura. Muchos de estos mecanismos tienen estructuras de datos internas con un espacio de estados muy complejo. Aparte de los efectos en el tiempo (sobre todo nos importa el tiempo) de ejecución, estos mecanismos son completamente transparentes a los programas que ejecuta el procesador.
Al igual que las arquitecturas convencioanles, esta arquitectura informal construída virtualmente sobre las arquitecturas formales se componen de registros, puertas y circuitos. Pero se les denomina de otra forma:
- Registros informales: Son capaces de almacenar datos, están implementados sobre los estados de componentes microarquitectónicos.
- Puertas informales: Componentes básicos de computación que transforman los datos almacenados en los registros informales.
- Circuitos informales: Conjuntos de puertas que implementan una lógica más compleja.
Ejemplo: Una arquitectura informal puede ofuscar código de malware para que su operación pasiva sea invisible hasta que se reciba un disparador. Y esto debemos comenzar a tenerlo MUY presente.
Aplicación práctica: FLEXO.
Como ejemplo de este concepto podemos citar a FLEXO. Ya que Flexo demuestra que las arquitecturas informales son una amenaza práctica a corto plazo.Permite crear máquinas informales a partir de código C/C++. Demuestra la practicidad al extender el empaquetador UPX para encriptar su carga útil y usar una máquina informal para la desencriptación. Flexo, permite calcular cualquier función booleana de N entradas.
Las máquinas informales son un nuevo enfoque para la computación que aprovecha las características microarquitectónicas de los procesadores. Tienen un gran potencial para la ofuscación de código y el desarrollo de malware.
Las arquitecturas informales son una tecnología emergente con el potencial de impactar significativamente el panorama de la seguridad. Recomiendo que se revise el github proporcionado acerca de Flexo pues demuestra la viabilidad de estas arquitecturas para aplicaciones del mundo real, lo que exige un mayor escrutinio y el desarrollo de estrategias de mitigación.
A fondo:
La idea subyacente consiste en utilizar efectos secundarios y conflictos en componentes microarquitecturales de los procesadores para realizar operaciones encubiertas.
El usar alternativas (canales laterales) para explotar el comportamiento no habitual de las arquitecturas en favor de un potencial ataque ya lo vimos con Spectre, en este caso ya se inferían estados de la microarquitectura usando medidas de tiempo. En este artículo se va a tratar el concepto de máquina (o arquitectura) informal, que son construcciones de código que aprovechan efectos secundarios en la microarquitectura (como predicción de saltos y efecto en las cachés) para realizar cálculos. Estos efectos no son observables mediante herramientas tradicionales como depuradores o emuladores, y ahí es precisamente donde radica su potencia para el desarrollo de malware (por ejemplo), especialmente peligroso en el caso de ransomware.
Las arqutecturas informales presentan grandes desafíos para los modelos de análisis y para las herramientas de detección de malware, dado que operan fuera del modelo arquitectónico de las herramientas de seguridad convencionales, como hemos visto en la introducción. Por ejemplo, pueden realizar tareas computacionales complejas (como implementar un SHA-1). Hay que remarcar que los cálculos realizados por estas arquitecturas son invisibles a las herramientas de análisis estático o dinámico, lo que supone un potencial enorme en la capacidad de ocultar código (tanto beneficioso como malicioso -es posible ocultar un código malicioso que crea una shell inversa, activado solo cuando recibe un disparador-).
¿Cómo funcionan?
Utilizan instrucciones del repertorio (especialmente cargas de memoria o saltos condicionales) y observan el tiempo de ejecución para inferir resultados. Aprovechan características tales como la ejecución especulativa (ver programa de ejemplo) para alterar estados microarquitecturales (observables indirectamente a través del tiempo de respuesta de las operaciones que usan la caché, los predictores de saltos, etc.) sin cambios en el estado arquitectónico observable.
Este tipo de comportamientos impacta directamente en las capacidades de defensa que actualmente conocemos. La complejidad de los efectos microarquitecturales dificulta significativamente el análisis y la emulación precisa, asegurando que los cálculos no puedan ser replicados fácilmente. Las técnicas actuales basadas en pruebas formales y análisis forense ya son prácticamente inutilizables contra estas máquinas informales ya que su estado no se encuentra en la memoria convencional, y por tanto estas herramientas de análisis tradicionales no pueden detectarlas.
¿Pero cuales son esos estados microarquitecturales que estas técnicas pueden usar para hacerse más difíciles de detectar?
Los procesadores modernos tienen múltiples capas funcionales, estos conceptos son fundamentales para todo ingeniero en informática. De hecho se dedican asignaturas obligatorias que guardan relación con este concepto en las titulaciones universitarias:
Capa arquitectónica (ISA, Instruction Set Architecture): La interfaz «visible» para los desarrolladores, que define cómo funcionan las instrucciones que un programa puede ejecutar.
Capa microarquitectural: Los componentes internos que implementan físicamente la arquitectura y optimizan la ejecución, como:
-Cachés.
-Predictores de saltos.
-Buffers de reordenamiento (relacionados con la optimización aplicada por los compiladores o por las unidades de hardware).
-Unidades de ejecución especulativa (relacionados con los predictores de saltos).
La microarquitectura no está diseñada para ser directamente manipulada por los programas, pero sus efectos indirectos (efectos secundarios) pueden ser analizados, por ejemplo, midiento el tiempo de las operaciones que se apoyan en ellos.
Considerando lo anterior, ¿cómo podemos -por ejemplo, midiendo el tiempo, aprovechar los elementos de la capa microarquitectural- para realizar otros cómputos no evidentes?
Efectos Secundarios
Consideremos el cambio de estado no intencionado en la microarquitectura que ocurre al ejecutar una instrucción.
Por ejemplo:
Evicción de caché: Acceder a una ubicación de memoria puede desplazar datos en la caché, dejando rastros que pueden ser medidos y utilizados para inferir información. Ver código de ejemplo 1.
Ejecución especulativa: El procesador predice el resultado de una rama condicional y ejecuta instrucciones antes de saber si eran correctas, dejando cambios temporales en componentes internos. Ver código de ejemplo 2.
Conflictos Microarquitecturales
Los conflictos ocurren cuando varios componentes del procesador compiten por los mismos recursos, lo que introduce comportamientos observables.
Ejemplos:
Colisiones en caché: Dos procesos que acceden a la misma línea de caché pueden provocar un «choque» que altera el rendimiento, detectable mediante la latencia de acceso.
Contención de recursos: Varias instrucciones que utilizan las mismas unidades funcionales (como ALU o FPU) pueden causar demoras detectables.
¿Cómo aprovechan estas cuestiones las máquinas informales?
Lo aprovechan para crear un sistema computacional basado en las transiciones de estados microarquitecturales, en lugar de depender exclusivamente de las instrucciones tradicionales.
Por ejemplo:
Los estados microarquitecturales, como el estado de la caché o las colisiones de un predictor de saltos, se usan como «memoria» para almacenar datos. Esto es lo que se conoce en el argot de este tipo de técnicas como registro informal. Ver código de ejemplo 1.
Las instrucciones regulares, como un acceso a memoria o una predicción de salto, se manipulan para alterar esos estados de manera controlada, realizando operaciones como suma o comparación. Que es algo parecido a una «operación», antes lo habíamos llamado puerta informal.
Al encadenar múltiples efectos secundarios y conflictos, somos capaces de construir operaciones completas, como una función de hash.
La potencia de esta técnica es evidente. Conseguimos invisibilidad ya que las operaciones realizadas a nivel microarquitectural no dejan rastros visibles en registros y memoria. Esto da paso a implementar funcionalidades en «canales laterales» del procesador. La complejidad es que debemos conocer exhaustivamente el hardware sobre el que trabajamos para poder explotarlo.
Y aquí, un ejemplo, en C. (poner código y ejemplo de ejecución) de la suma especulativa. Ver código de ejemplo 2.
Acceso a más documentación:
Privacidad en la Era Digital
En un mundo marcado por la digitalización tan acelerada, las políticas de privacidad han evolucionado (aunque de manera dispar y no tan rápido como la digitalización) para responder a la creciente preocupación sobre el manejo de los datos personales. Desde finales del siglo XX las políticas de privacidad han reflejado tanto avances tecnológicos como una mayor sensibilidad regulatoria y social. Siempre para dar respuesta a avances como el comercio electrónico y a la protección de datos.
A finales del siglo XX, las políticas de privacidad comenzaron a consolidarse como herramientas utiles para la transparencia y confianza. En [1] los autores ofrecieron (2007) una primera revisión integral de los lenguajes de estas políticas, sentando las bases para su análisis sistemático. La entrada en vigor del Reglamento General de Protección de Datos (GDPR) en mayo de 2018 marcó un hito global, no sólo para las empresas europeas, sino también para aquellas que operan a nivel internacional, estableciendo un estándar de cumplimiento obligatorio. La multa de 50 millones de euros a Google en 2019 por falta de transparencia en la gestión de datos personales supuso un fenomenal respaldo a este marco que subrayó la importancia de la claridad en las prácticas organizativas.
Hoy en día, +162 países han promulgado leyes de privacidad de datos, mientras que +20 trabajan en proyectos legislativos. La investigación en políticas de privacidad ha ampliado su alcance a numerosos sectores siendo los más relevantes sectores como el de salud. A todo esto se le suma la aparición de herramientas basadas en aprendizaje automático y procesamiento del lenguaje natural que, como añadido importante, permiten analizar aspectos como la legibilidad, la accesibilidad y el cumplimiento normativo de estas políticas.
Numerosos investigadores han destacado notables discrepancias entre las prácticas de manejo de datos y las declaraciones de privacidad, evidenciando la necesidad de sistemas de revisión y control más robustos. Sectores como el de la salud enfrentan desafíos específicos relacionados con la claridad, la transparencia y el respeto a los derechos de los usuarios.
Los marcos regulatorios (políticas), liderados por la Unión Europea con el GDPR, han establecido un estándar global para el manejo ético y legal de los datos. Sin embargo, la implementación de estas politicas enfrenta obstáculos, desde la falta de uniformidad en las leyes regionales hasta las brechas en la comprensión y aplicación por parte de las organizaciones. Casos como la aplicación de técnicas de aprendizaje (machine learning, ML) para avanzar en la investigación sobre la legibilidad de las políticas demuestran que, en muchos sectores, estas políticas permanecen inaccesibles para el usuario promedio, lo que dificulta la confianza y la transparencia.
La inteligencia artificial generativa y otros campos más amplios (como el ML) añade otra capa de complejidad. Por un lado, ofrece herramientas para analizar y mejorar estas políticas; por otro, plantea riesgos éticos y de seguridad que requieren atención regulatoria. Desde la creación de deepfakes hasta el uso malintencionado en ataques de ingeniería social, estos modelos amplifican los desafíos inherentes al manejo de datos sensibles.
En síntesis, las políticas de privacidad han recorrido un largo camino, pero su desarrollo sigue siendo esencial en un mundo donde la tecnología redefine constantemente las reglas del juego. La colaboración entre reguladores, investigadores y la industria es crucial para garantizar que estas políticas evolucionen en paralelo con las tecnologías que buscan regular, promoviendo un equilibrio entre innovación, ética y derechos fundamentales.
Indudablemente, las ténicas de IA y ML han favorecido analizar la aplicación y expresión de éstas políticas, demostrando que aún queda mucho campo en el que avanzar.
Referencias
[1] Ponnurangam Kumaraguru, Lorrie Cranor, Jorge Lobo, and Seraphin Calo. 2007. A survey of privacy policy languages. 3rd Symposium on Usable Privacy and Security: Workshop on Usable IT Security Management (USM’07).ACM.
Volver a casa: Una experiencia inolvidable en mi alma mater (UGR). Cátedra Telefónica – UGR.
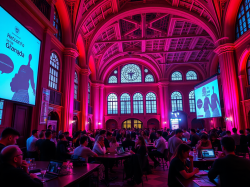
Regresar a la Universidad de Granada, mi alma mater, para impartir una conferencia sobre los Fundamentos de seguridad de hardware y TPM 2.0 ha sido una experiencia profundamente significativa. No solo fue una oportunidad para compartir conocimiento, sino también para reconectar con la institución que marcó los inicios de mi trayectoria profesional.

En el marco de la Cátedra Telefónica-UGR sobre IA, Ciberseguridad y Sociedad Cognitiva, abordamos los desafíos y oportunidades de los estándares modernos de seguridad como el TPM 2.0, un pilar esencial para la confianza digital en dispositivos empotrados y sistemas críticos. Fue inspirador ver el interés de estudiantes, docentes y profesionales que, con sus preguntas y reflexiones, enriquecieron aún más la experiencia.

Volver a las aulas y los espacios donde comenzó todo me recordó lo importante que es contribuir al crecimiento de la próxima generación de expertos en ciberseguridad. Gracias a todos los asistentes por su energía, curiosidad y ganas de aprender.
Granada, siempre es un placer volver a ti. ❤️

Enlace a la Cátedra Telefónica-UGR
Este regreso ha sido especialmente emotivo, ya que este año se cumplen 25 años desde que me gradué como parte de la primera promoción de ingenieros de la ETSIIT. Recordar aquello junto con las lecciones aprendidas ha sido un viaje lleno de nostalgia y orgullo. Saber que la ETSIIT sigue formando mentes brillantes que afrontan los desafíos tecnológicos del futuro es un motivo de esperanza y admiración.
Agradezco la invitación a la Dirección de la Cátedra.
¿Confidential Computing o Cryptographic Computing? El Futuro de la Computación Segura.
En un mundo donde los datos son el nuevo oro, proteger su privacidad y seguridad se ha convertido en una prioridad esencial. La computación segura, que busca mantener los datos protegidos incluso mientras están siendo procesados, es una respuesta a los desafíos impuestos por normativas más estrictas y ataques cibernéticos cada vez más sofisticados. Dentro de este ámbito, dos enfoques destacan como soluciones líderes: la computación criptográfica (destacanado dentro de ésta a la criptografía homomórfica) y la computación confidencial. Aunque ambos comparten el mismo objetivo, sus métodos y aplicaciones presentan diferencias clave que vale la pena explorar.
La computación criptográfica se apoya en técnicas avanzadas como el cifrado homomórfico y el cómputo multipartito seguro. Estas tecnologías permiten realizar cálculos directamente sobre datos cifrados, sin necesidad de descifrarlos, asegurando un nivel extremo de privacidad. Esto es particularmente útil en situaciones donde los datos deben permanecer protegidos de todos los actores involucrados, incluyendo los sistemas que ejecutan los cálculos. Sin embargo, este enfoque enfrenta importantes desafíos prácticos. La complejidad matemática que lo respalda implica tiempos de procesamiento significativamente mayores, lo que lo hace menos eficiente para aplicaciones intensivas como el aprendizaje automático. Además, su implementación requiere conocimientos especializados en criptografía, lo que puede limitar su adopción en organizaciones con recursos técnicos más limitados.
Por otro lado, la computación confidencial utiliza entornos de ejecución confiables, también conocidos como TEEs, para crear espacios seguros dentro del hardware donde los datos pueden ser procesados directamente. A diferencia de la computación criptográfica, este enfoque permite trabajar con datos en texto plano, aprovechando todo el poder del procesador. Esto se traduce en un alto rendimiento y una implementación relativamente sencilla, especialmente porque grandes proveedores en la nube, como AWS o Azure, ya integran estas tecnologías en sus servicios. Sin embargo, esta dependencia del hardware introduce ciertos riesgos. Un compromiso en el diseño de los TEEs podría exponer información sensible, y los usuarios deben confiar plenamente en las garantías ofrecidas por los fabricantes.

Ambos enfoques tienen aplicaciones concretas en diversos sectores. En el ámbito de la salud, la computación criptográfica permite a las organizaciones entrenar modelos predictivos sin compartir datos sensibles de los pacientes, mientras que la computación confidencial es una excelente opción para integrar servicios en la nube de manera eficiente y segura. En el sector financiero, la computación confidencial facilita la construcción de modelos con datos distribuidos entre diferentes sucursales, mientras que la criptografía avanzada asegura la privacidad total cuando la confidencialidad es prioritaria.
Elegir entre computación criptográfica y confidencial depende en gran medida de las necesidades específicas de cada caso. Si la prioridad es la máxima seguridad y la privacidad absoluta, aunque a costa de un mayor tiempo de procesamiento, la computación criptográfica es la elección ideal. Si, por el contrario, se requiere un alto rendimiento en tiempo real y se confía en la integridad del hardware, la computación confidencial es la alternativa más práctica.
El futuro de la computación segura podría estar en la integración de ambas tecnologías, combinando la robustez de la criptografía avanzada con la eficiencia de los entornos confiables de hardware. Por ahora, cada organización debe evaluar sus requisitos específicos y las capacidades de su infraestructura antes de adoptar una solución.
En la era digital, proteger los datos no es solo una cuestión técnica, sino un compromiso ético con la privacidad y la confianza de los usuarios. Tanto la computación criptográfica como la confidencial son herramientas clave para garantizar un manejo seguro de la información, marcando el camino hacia un mundo digital más protegido y confiable.
Impacto en los modelos de aprendizaje: un enfoque paradigmático
Un aspecto crucial a considerar sobre la computación segura es cómo puede impactar negativamente el entrenamiento de modelos de aprendizaje automático, especialmente en entornos sensibles como el de la salud. Si bien garantizar la privacidad de los datos es imprescindible en este sector, la naturaleza altamente restrictiva de las técnicas de computación segura, particularmente la computación criptográfica, puede convertirse en un obstáculo significativo para el desarrollo y la implementación eficiente de estos modelos.
El entrenamiento de modelos de aprendizaje automático, como los utilizados para detectar enfermedades, predecir tratamientos o personalizar diagnósticos, implica procesar grandes cantidades de datos en múltiples iteraciones. En un entorno que prioriza la privacidad mediante métodos criptográficos, como el cifrado homomórfico o el cómputo multipartito seguro, cada cálculo debe realizarse sobre datos cifrados. Aunque esto protege completamente la información de los pacientes, la sobrecarga computacional resultante es sustancial. Operaciones que en un entorno tradicional tardarían segundos pueden extenderse a horas o días. Esto no solo retrasa el entrenamiento del modelo, sino que también limita la capacidad de iterar rápidamente y ajustar parámetros, lo cual es esencial para mejorar la precisión del modelo.
En el caso de la computación confidencial, aunque la eficiencia mejora considerablemente, sigue existiendo un compromiso inherente. Dado que se depende de hardware especializado, cualquier limitación en la disponibilidad o la capacidad de los entornos confiables podría restringir el acceso a los recursos necesarios para procesar datos masivos. Además, este enfoque no elimina completamente las preocupaciones sobre la privacidad, ya que el procesamiento de datos en texto plano dentro de los enclaves sigue generando riesgos residuales, especialmente si el hardware es comprometido.
En un sector como la salud, donde los datos son extremadamente sensibles y la precisión del modelo puede marcar la diferencia entre un diagnóstico temprano o uno tardío, este dilema se magnifica. La necesidad de equilibrar privacidad y eficiencia crea una tensión que todavía no se ha resuelto completamente. Las soluciones actuales exigen compromisos que pueden impactar tanto en la seguridad de los datos como en la velocidad y calidad del entrenamiento.
La reflexión más importante aquí es que, aunque la computación segura representa un avance crucial en la protección de la privacidad, no es una panacea. Para aplicaciones críticas como el entrenamiento de modelos en el sector salud, es imprescindible seguir investigando y desarrollando tecnologías híbridas que combinen la privacidad estricta con una eficiencia adecuada. Sin este equilibrio, corremos el riesgo de que las ventajas de la computación segura se vean eclipsadas por sus limitaciones prácticas, lo que podría retrasar la adopción de soluciones innovadoras en áreas donde son más necesarias.

